Vì sao ChatGPT quên nội dung khi dán tài liệu dài? Giới hạn ngữ cảnh và 5 cách xử lý văn bản từ 50 đến 300 trang (cập nhật 10/2026)
Vì sao ChatGPT quên nội dung khi dán tài liệu dài? Giới hạn ngữ cảnh và 5 cách xử lý văn bản từ 50 đến 300 trang (cập nhật 10/2026)
Trả lời ngay:
- ⛔ AI không đọc tài liệu theo trang mà theo token, và mỗi lần trả lời nó chỉ giữ được một lượng token nhất định (gọi là cửa sổ ngữ cảnh). Dán quá lượng đó thì phần đầu bị cắt bỏ hoặc bị nén lại. Đó là lúc AI "quên".
- ⚠️ Lọt vừa cửa sổ chưa chắc đã được đọc kỹ. Nghiên cứu Lost in the Middle (TACL, 2024) cho thấy mô hình dùng tốt thông tin ở đầu và cuối, nhưng hay bỏ sót thông tin nằm ở giữa văn bản dài.
- ✅ Cách xử lý chắc chắn nhất là chia để trị: cắt tài liệu theo chương, xử lý từng phần riêng, rồi mới ghép kết quả. Bài này hướng dẫn 5 cách, từ dễ đến khó, kèm số đo thật trên một văn bản 689 điều.
Token là gì, và tài liệu của bạn "nặng" bao nhiêu token?
Mô hình ngôn ngữ không nhìn thấy chữ như người đọc. Nó cắt văn bản thành các mảnh nhỏ gọi là token: có khi là một từ, có khi là một phần của từ. Tiếng Việt có dấu nên thường tốn nhiều token hơn tiếng Anh cho cùng một lượng ý.
Để có con số thật thay vì ước đoán, chúng tôi đưa toàn văn Bộ luật Dân sự 2015 (689 điều, 82.805 từ) qua API của hai mô hình và đọc số token mà chính nhà cung cấp tính:
| Mô hình | Số token của cả bộ luật | Token trên mỗi từ |
|---|---|---|
| MiniMax-M3 | 210.300 | 2,54 |
| DeepSeek | 168.834 | 2,04 |
Đo ngày 26/10/2026. Mỗi mô hình có bộ tách token riêng nên cùng một văn bản cho ra số khác nhau.
Quy ra trang: nếu một trang khoá luận chứa khoảng 500 từ, thì một trang tiếng Việt tốn khoảng 1.000–1.300 token. Một giáo trình 300 trang chữ thuần sẽ vào khoảng 300.000–380.000 token.
Con số này giải thích vì sao cùng một tài liệu, có AI đọc được trọn vẹn còn AI khác thì "quên": nó phụ thuộc vào cửa sổ ngữ cảnh của mô hình bạn đang dùng, và vào gói bạn đang trả tiền.
Vì sao AI "quên": hai nguyên nhân khác nhau
Hai hiện tượng này trông giống nhau từ phía người dùng, nhưng cách chữa khác nhau.
Nguyên nhân 1: tràn cửa sổ ngữ cảnh. Tài liệu cộng với lịch sử trò chuyện vượt quá số token mô hình giữ được. Khi đó công cụ chat phải bỏ bớt, thường là bỏ phần cũ nhất. Dấu hiệu: AI trả lời như chưa từng thấy chương 1, hoặc hỏi lại thông tin bạn đã đưa.
Nguyên nhân 2: lọt vừa nhưng bị "lạc ở giữa". Liu và cộng sự (2024) thử nghiệm nhiều mô hình và thấy hiệu suất cao nhất khi thông tin cần dùng nằm ở đầu hoặc cuối ngữ cảnh, và giảm đáng kể khi nó nằm ở giữa, kể cả với các mô hình được quảng cáo là đọc được văn bản dài. Dấu hiệu: AI trả lời đúng về mở bài và kết luận, nhưng bịa hoặc bỏ qua chi tiết ở chương 3–4.
Nguyên nhân phụ: lịch sử chat cộng dồn. Mỗi câu hỏi, mỗi câu trả lời trong cùng cuộc trò chuyện đều chiếm thêm token. Một cuộc chat kéo dài cả buổi về khoá luận có thể "nặng" hơn chính khoá luận.
5 cách xử lý tài liệu dài, theo độ dài tài liệu
Chọn cách theo tình huống của bạn, không cần làm cả năm.
Cách 1 — Dưới 30 trang: đưa nguyên file, nhưng hỏi đúng chỗ
Tài liệu ngắn thì đưa cả file là được. Điều cần sửa là cách hỏi:
- Nêu rõ vị trí: "Trong mục 2.3, tác giả định nghĩa X thế nào?" thay vì "Tài liệu nói gì về X?"
- Bắt AI dẫn nguồn trong tài liệu: "Trích nguyên văn câu bạn dựa vào, kèm số mục." AI không trích được thì nhiều khả năng nó đang đoán.
Cách 2 — 30 đến 100 trang: đọc theo mục lục trước, chi tiết sau
Đừng hỏi ngay câu chi tiết. Lượt đầu chỉ yêu cầu dàn ý: các chương, mỗi chương nói gì, nằm ở trang nào. Lượt sau mới hỏi sâu vào từng chương.
Lợi ích: bạn có bản đồ để kiểm tra câu trả lời, và AI có khung để định vị. Quy trình chi tiết nằm trong bài tóm tắt tài liệu 100 trang bằng AI mà không bị bịa.
Cách 3 — 100 đến 300 trang: chia để trị
Đây là kỹ thuật cốt lõi của bài. Thay vì đưa cả tài liệu và mong AI nhớ hết:
- Cắt theo ranh giới tự nhiên: chương, phần, điều khoản. Không cắt theo số trang cố định, vì một ý bị cắt đôi sẽ làm AI hiểu sai cả hai nửa.
- Mỗi phần một cuộc trò chuyện mới, để lịch sử chat không cộng dồn.
- Mỗi lượt giao cùng một nhiệm vụ, cùng một khuôn trả lời. Ví dụ: "Tóm tắt chương này trong 5 gạch đầu dòng, liệt kê mọi số liệu kèm số trang." Khuôn giống nhau thì kết quả mới ghép được.
- Ghép kết quả ở lượt cuối: đưa 6–8 bản tóm tắt ngắn (chứ không phải tài liệu gốc) vào một cuộc chat mới để tổng hợp.
Mấu chốt: ở bước 4, AI chỉ phải đọc vài nghìn token đã chắt lọc, không phải vài trăm nghìn token thô.
Cách 4 — Cần sửa tài liệu: chỉ đưa đoạn cần sửa
Lỗi phổ biến nhất là dán cả khoá luận rồi bảo "sửa giúp mục 2.1". AI thường viết lại cả bài, và trong lúc viết lại thì làm rơi đoạn, đổi số liệu, đổi trích dẫn ở những chỗ bạn không nhờ sửa.
Cách đúng: chỉ đưa đoạn cần sửa, kèm 1–2 đoạn xung quanh để giữ mạch, rồi tự dán kết quả vào đúng chỗ. Hướng dẫn từng bước ở bài sửa một đoạn trong khoá luận 80 trang mà không làm hỏng phần còn lại.
Cách 5 — Cần đối chiếu nhiều chỗ: tìm trước, đọc sau
Kiểm tra nhất quán (số liệu chương 3 có khớp chương 4 không, trích dẫn có đủ trong danh mục không) là việc mà AI đọc "trọn gói" làm kém nhất, vì nó phải giữ nhiều điểm ở giữa văn bản cùng lúc.
Cách đúng: liệt kê trước mọi chỗ xuất hiện của thứ cần đối chiếu (mọi con số cỡ mẫu, mọi tên tác giả), rồi mới so. Trong Word, Ctrl+F làm được phần liệt kê. Checklist đầy đủ ở bài kiểm tra nhất quán khoá luận trước khi nộp.
Bảng chọn cách nhanh
| Tình huống | Độ dài | Cách | Rủi ro nếu làm sai |
|---|---|---|---|
| Hỏi đáp tài liệu ngắn | < 30 trang | 1 — Đưa nguyên file, hỏi có vị trí | AI trả lời chung chung |
| Tóm tắt, nắm ý chính | 30–100 trang | 2 — Mục lục trước, chi tiết sau | Bịa chi tiết ở giữa |
| Tóm tắt giáo trình, bộ hồ sơ | 100–300 trang | 3 — Chia để trị | Tràn ngữ cảnh, "quên" chương đầu |
| Sửa một phần | Mọi độ dài | 4 — Chỉ đưa đoạn cần sửa | Hỏng phần không nhờ sửa |
| Kiểm tra nhất quán | Mọi độ dài | 5 — Liệt kê trước, so sau | Sót lỗi nằm ở giữa |
Checklist trước khi đưa tài liệu dài cho AI
- Ước lượng số token: số từ × 2,5 (với tiếng Việt)
- Biết cửa sổ ngữ cảnh của mô hình và gói mình đang dùng
- Tài liệu có mục lục, đề mục rõ ràng (AI định vị theo đề mục)
- Đã chọn một trong 5 cách ở trên theo tình huống
- Mỗi phần việc lớn là một cuộc trò chuyện mới
- Yêu cầu AI trích nguyên văn và ghi vị trí cho mọi khẳng định quan trọng
- Tự mở tài liệu gốc đối chiếu ít nhất 2–3 chỗ AI trích
LOSAN AI: cách đơn giản nhất để làm việc với tài liệu dài
Năm cách trên đều làm được bằng tay với bất kỳ công cụ AI nào. Cái giá là thời gian: cắt file, mở nhiều cuộc chat, ghép kết quả. Tính năng Dự án của LOSAN AI được làm để bỏ bớt phần việc tay đó:
- Tải tài liệu lên một lần, mọi cuộc trò chuyện trong dự án dùng lại. Không phải dán lại mỗi phiên.
- AI đọc hết các trang. Mô hình mặc định có cửa sổ ngữ cảnh 1 triệu token, rộng gấp gần 5 lần toàn văn Bộ luật Dân sự 2015. Văn bản cỡ vài trăm trang không bị tràn ngữ cảnh và không quên đoạn giữa.
- Khi sửa, AI chỉ tìm đúng phần cần sửa rồi thay, không viết lại cả bài, nên những phần bạn không nhờ sửa được giữ nguyên.
Chúng tôi thử trực tiếp: chèn một dòng ghi chú giả vào đầu (sau Điều 29), giữa (sau Điều 324) và cuối (sau Điều 653) của bộ luật, rồi hỏi mô hình mặc định dòng đó nằm ở đâu. Cả 3/3 lần đều đúng cả nội dung lẫn số điều, mỗi lần 8–11 giây. Đây là phép tra một chi tiết, mỗi vị trí thử một lần; nó chưa phải phép đo cho mọi loại câu hỏi.
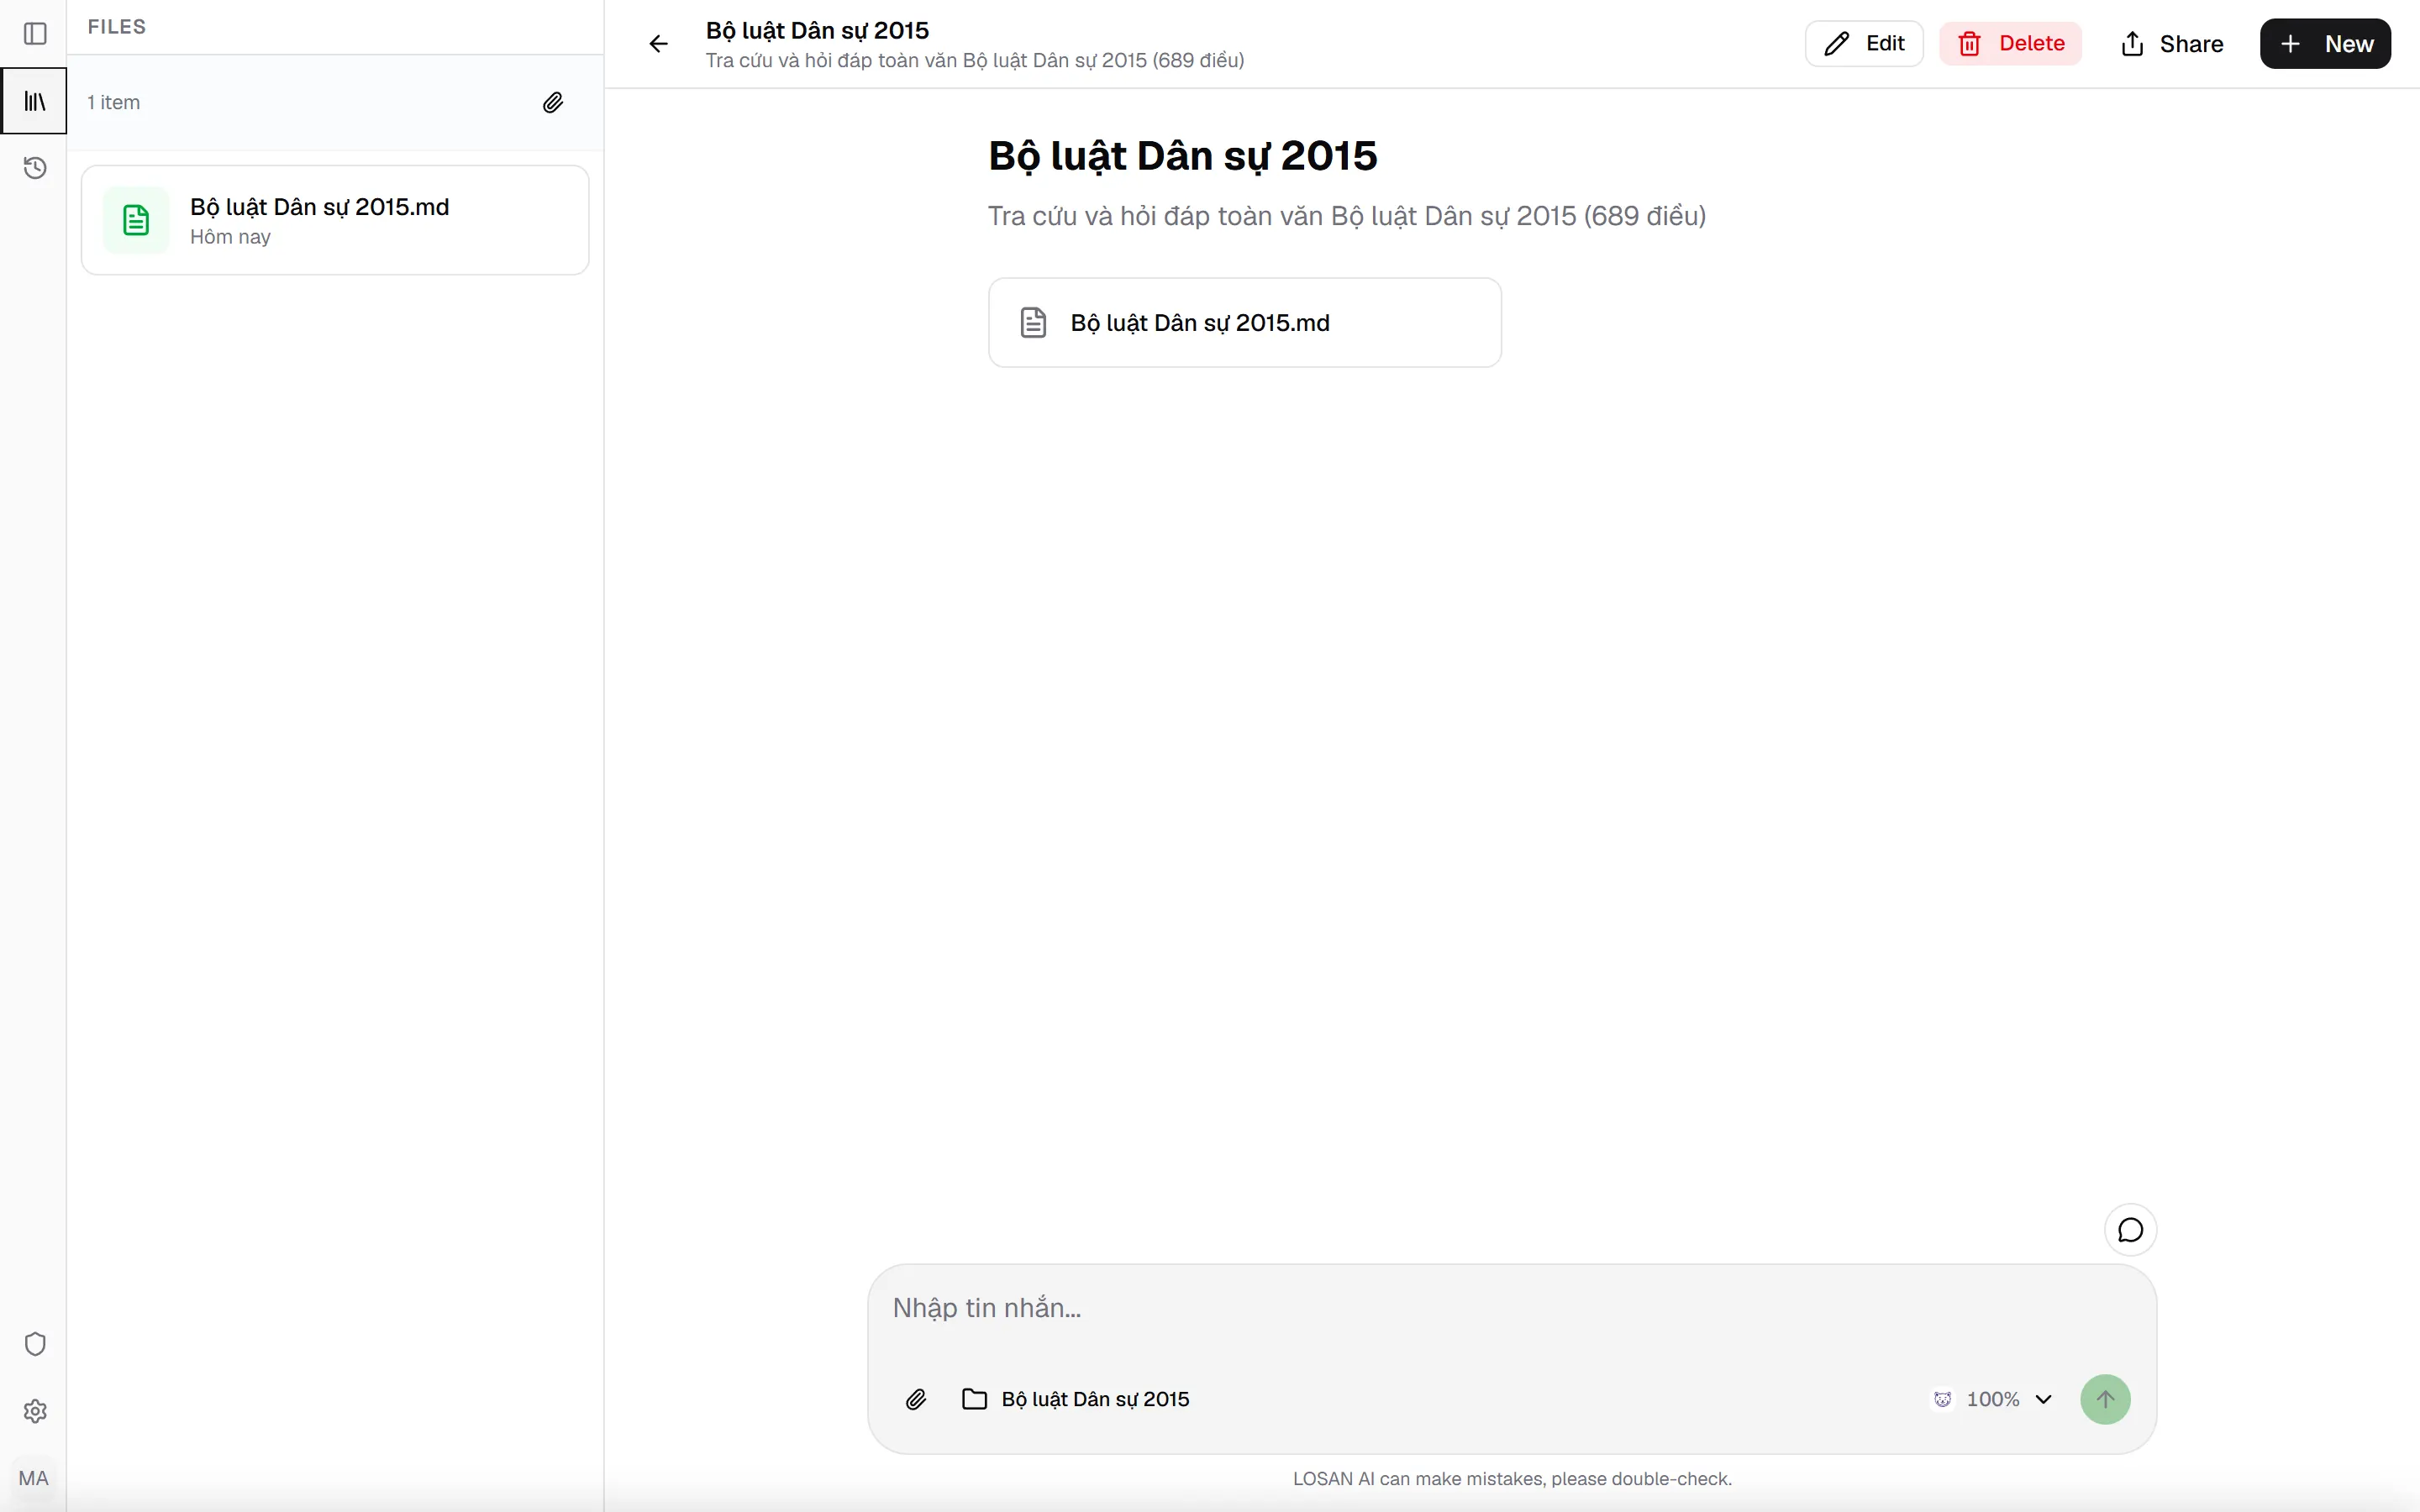
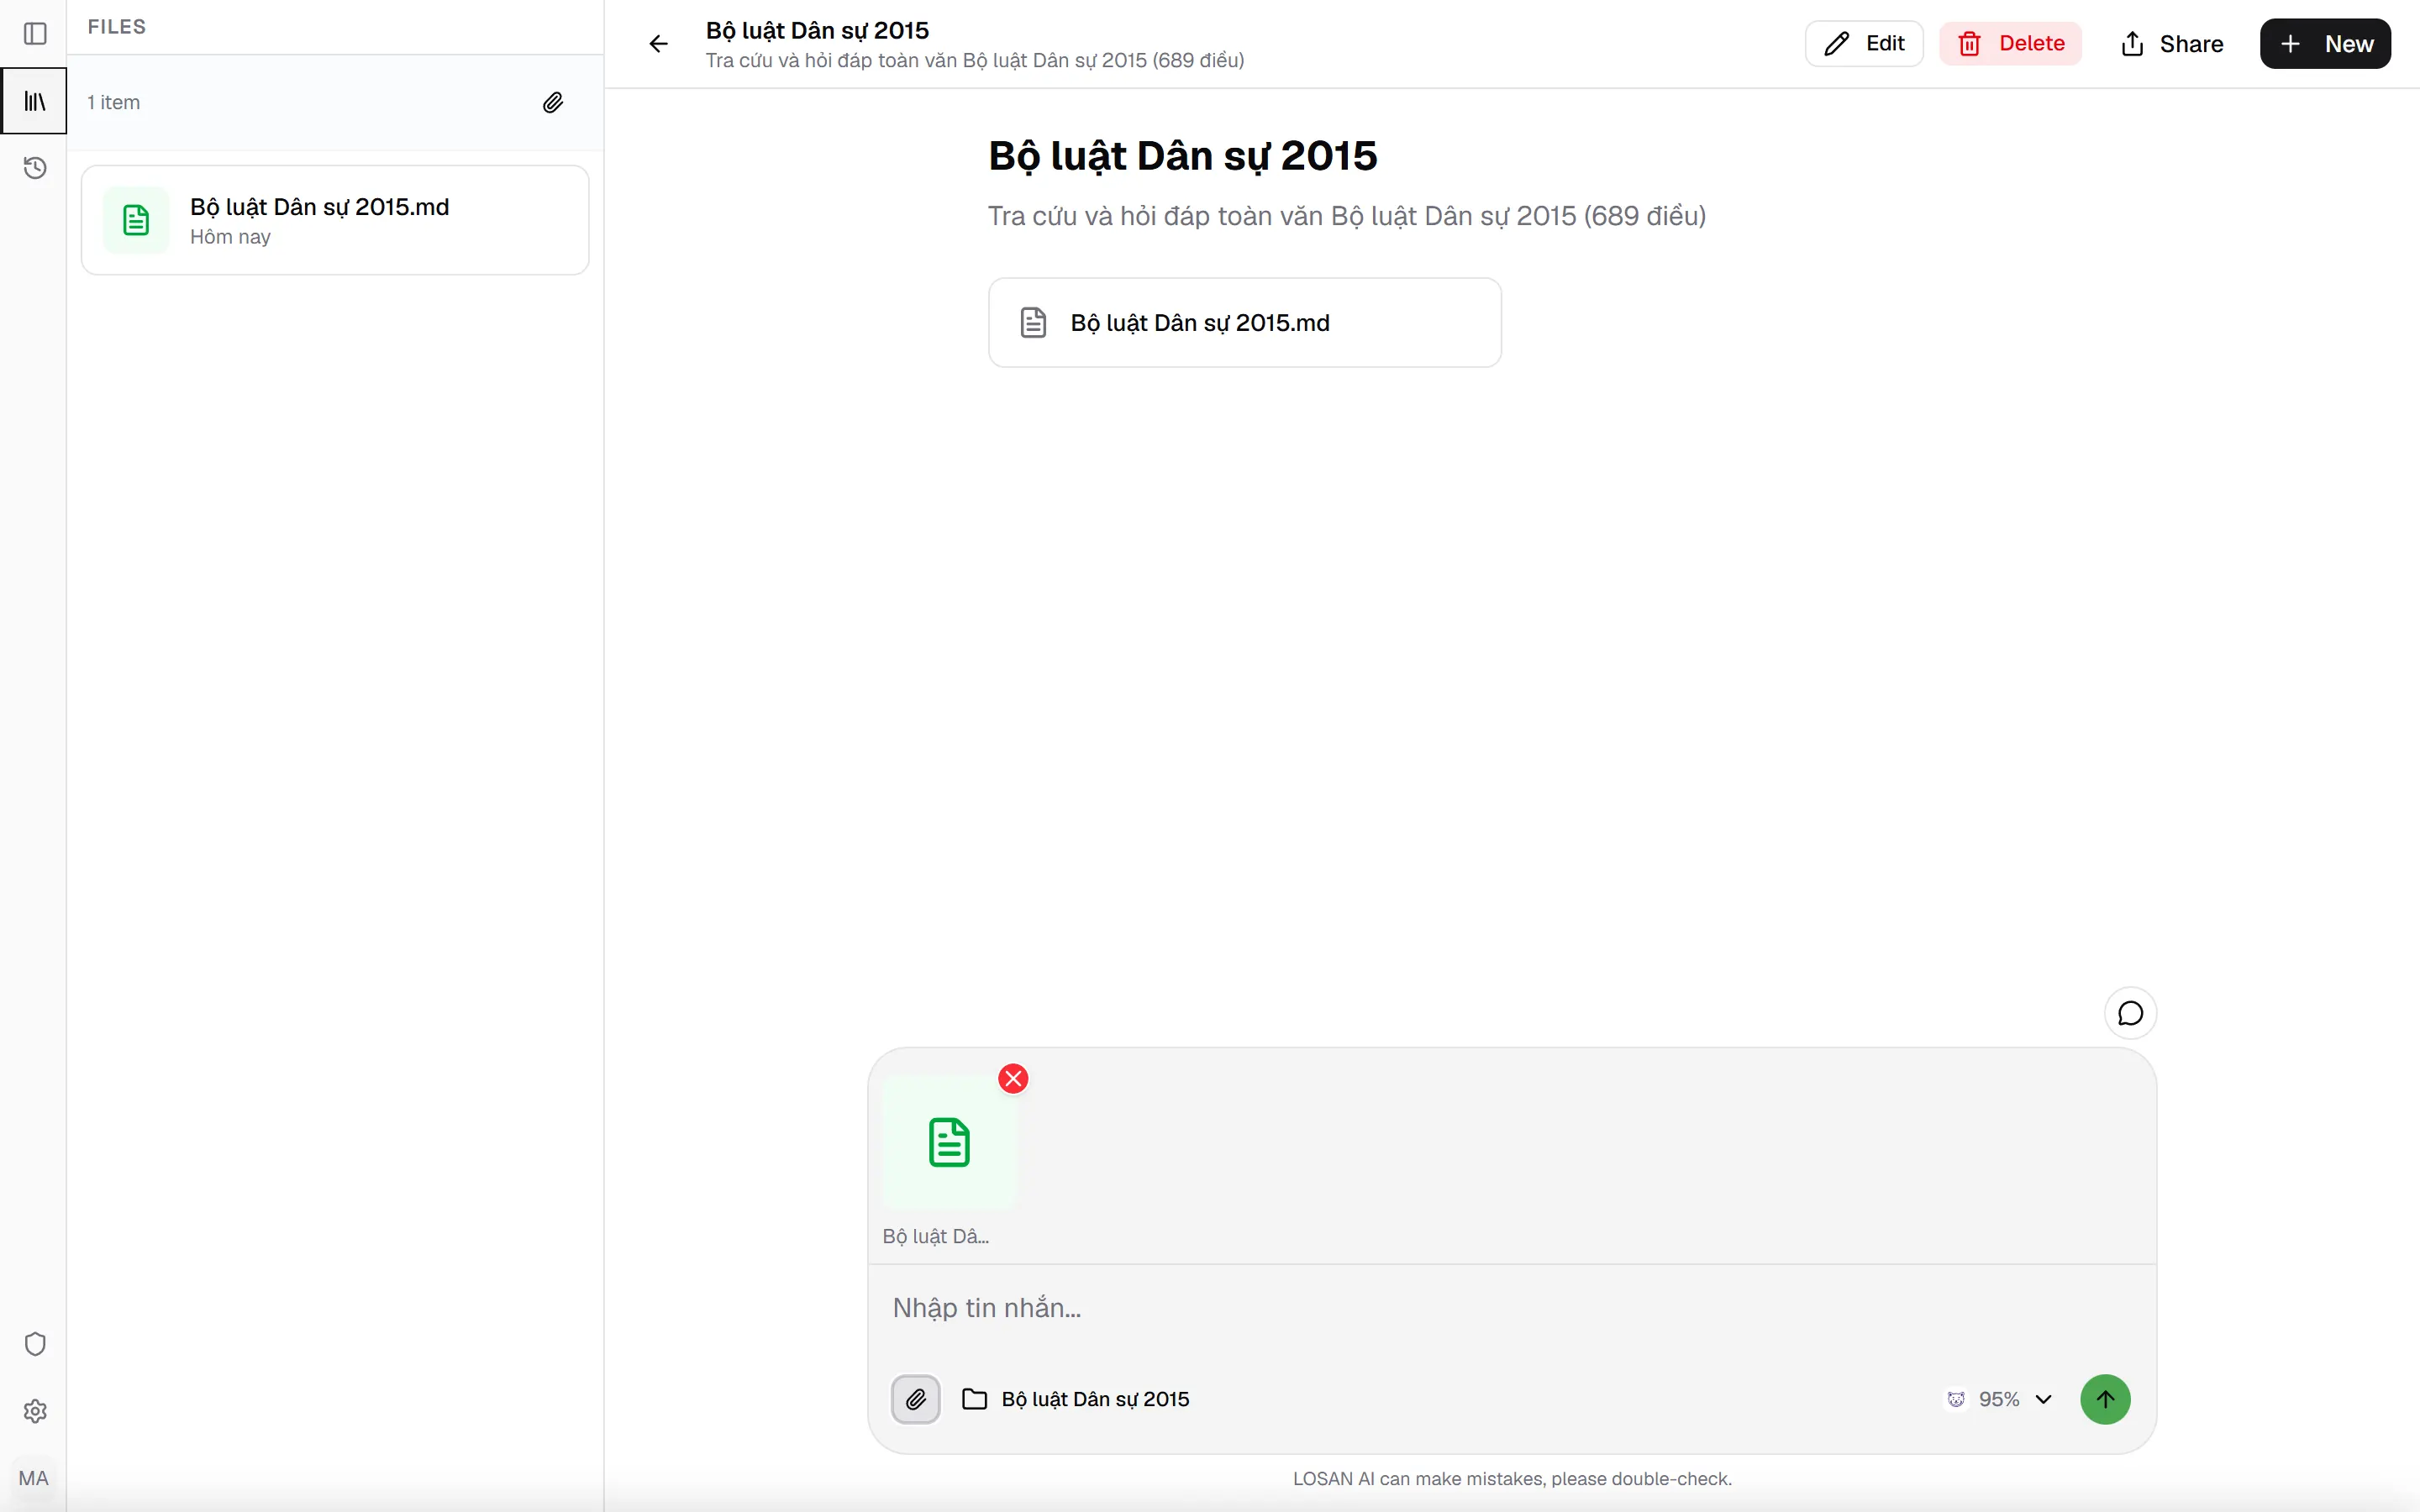
Cách dùng: tạo dự án, tải file lên, bấm biểu tượng kẹp giấy trong ô chat để chọn file đó, rồi đặt câu hỏi.
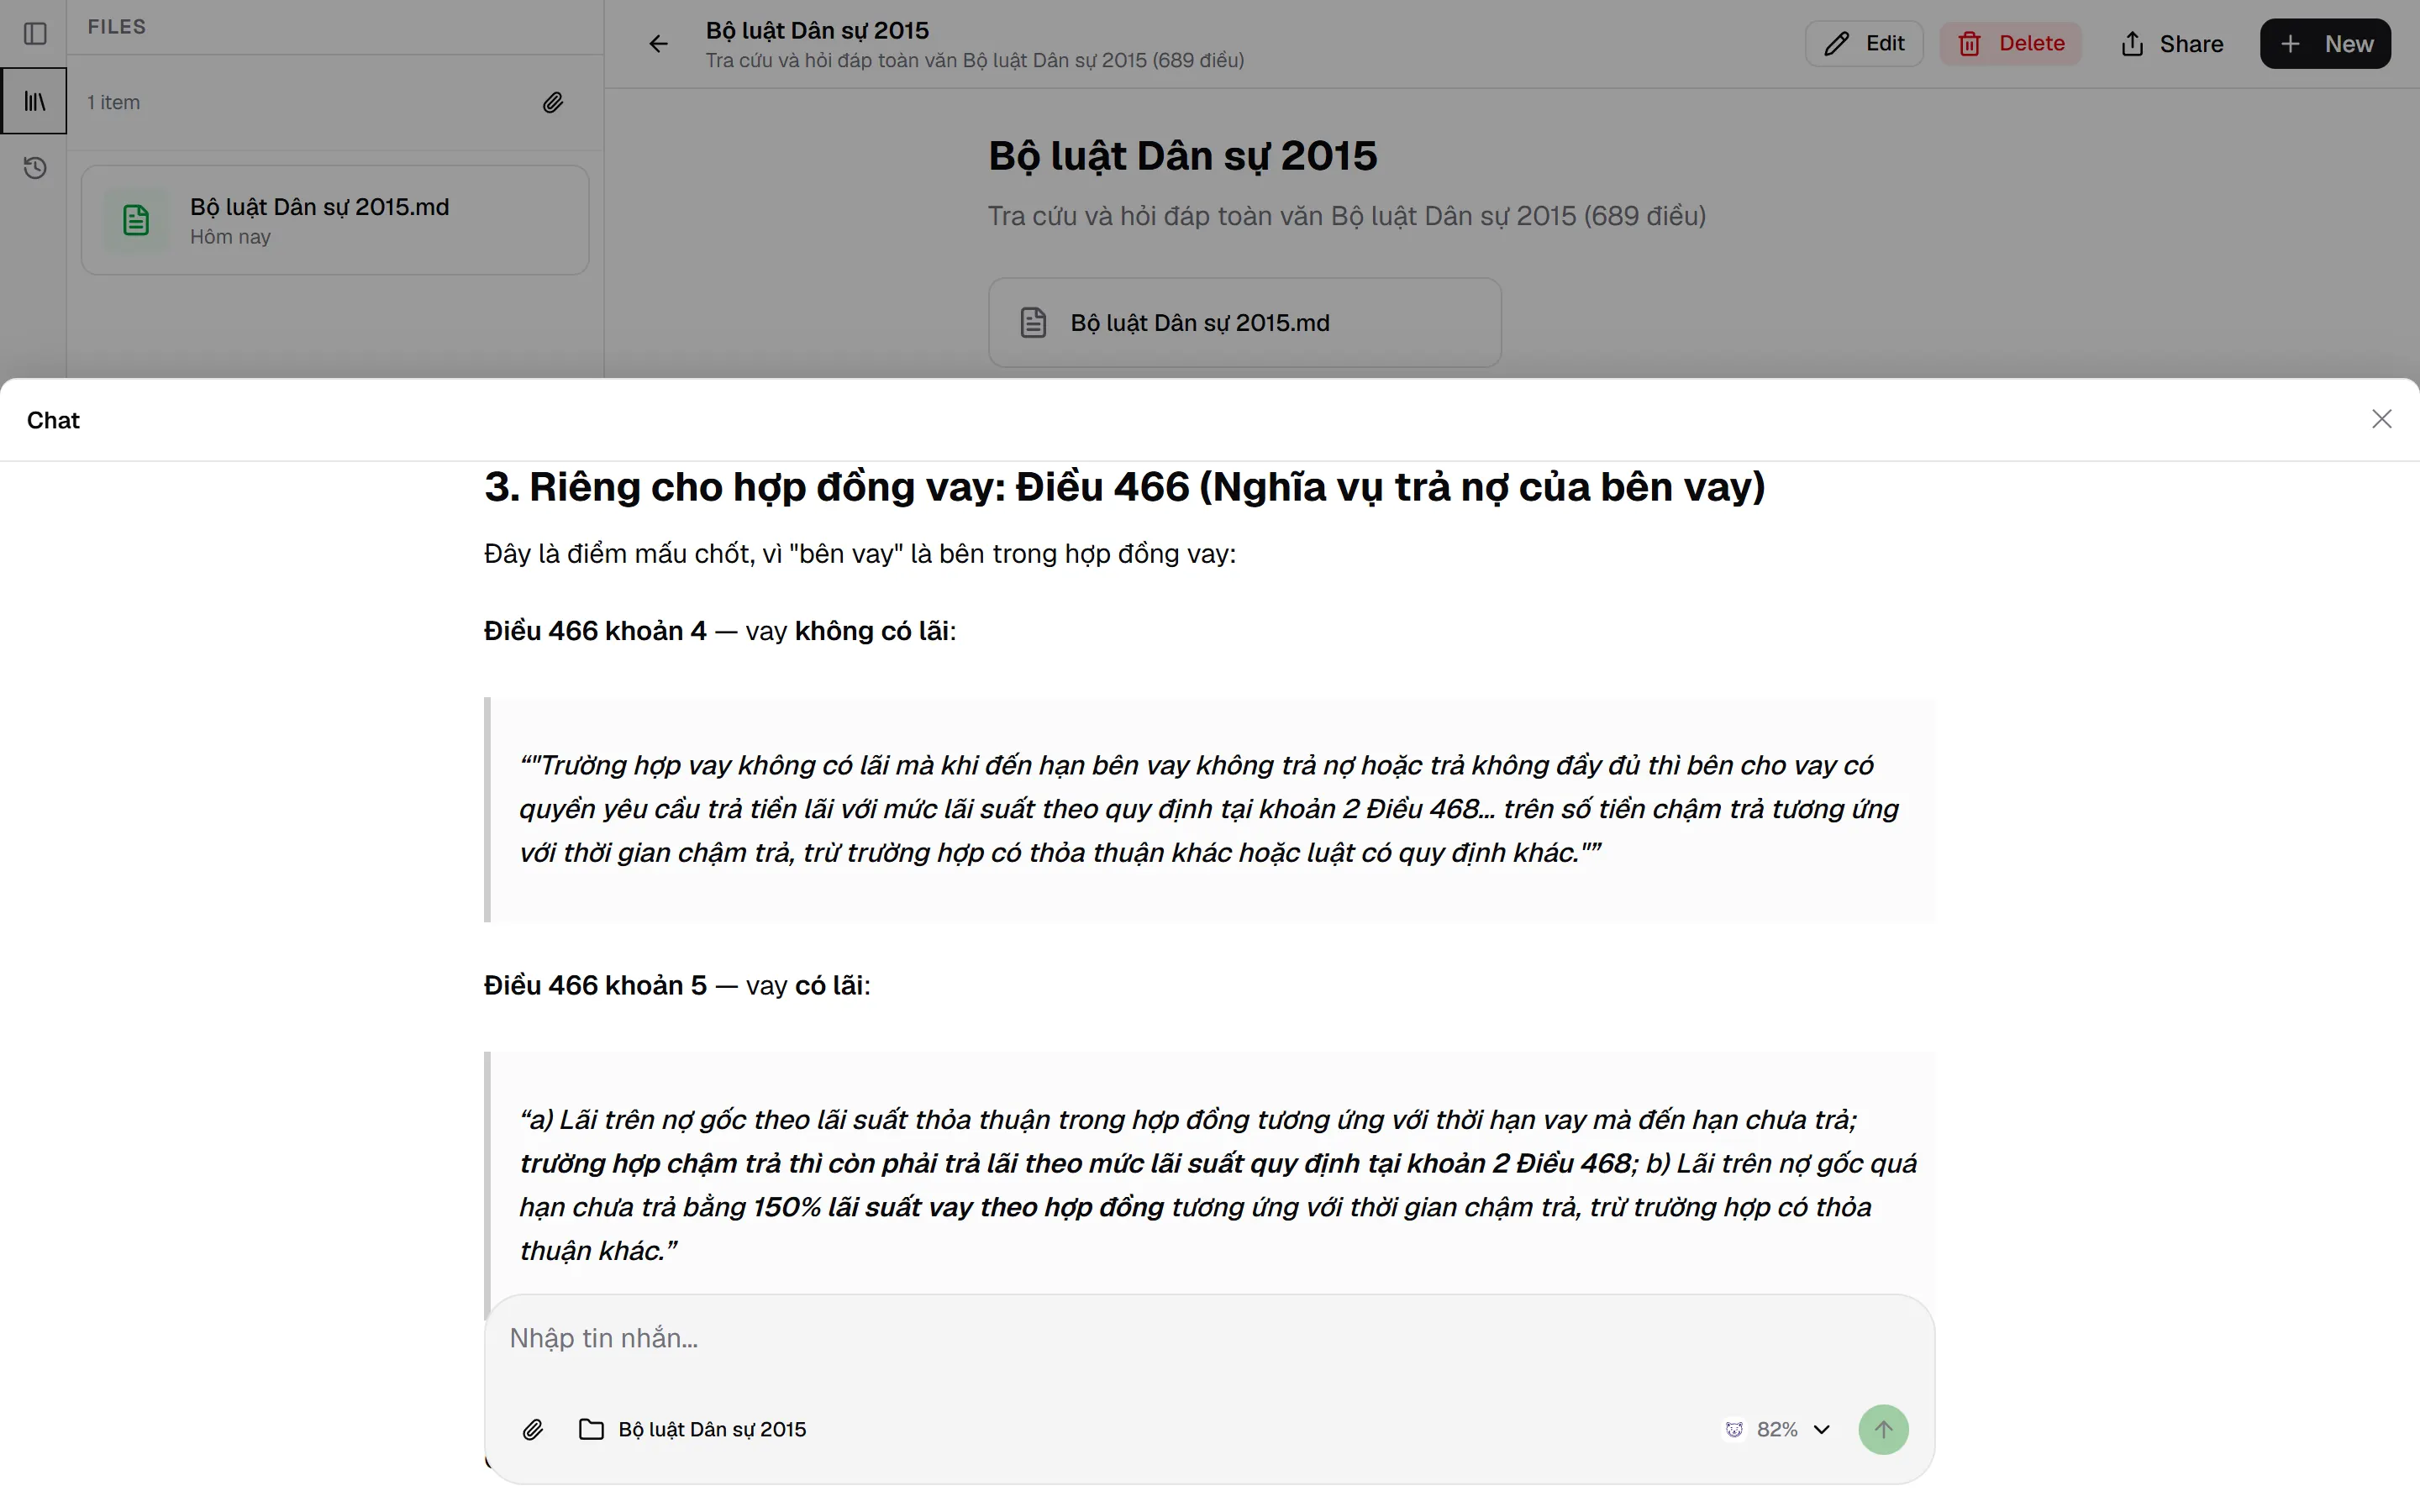
Hỏi một câu mà đáp án nằm giữa bộ luật (Điều 466, trong tổng số 689 điều), AI trích đúng khoản và nguyên văn điều luật:
Giới hạn cần nói thật: 1 triệu token tương đương khoảng 750–800 trang chữ tiếng Việt. Tài liệu dài hơn, hoặc khi gộp nhiều cuốn giáo trình vào một lần hỏi, thì vẫn nên cắt. Lúc đó hãy để mỗi chương một file trong cùng dự án, đúng tinh thần chia để trị ở trên.
👉 Tạo dự án đầu tiên: losan.ai/project
Câu hỏi thường gặp
Dán tài liệu vào ô chat và tải file lên có khác nhau không? Với phần lớn công cụ, cả hai cuối cùng đều thành token trong ngữ cảnh, nên giới hạn như nhau. Khác biệt là file tải lên thường được giữ lại để dùng cho các lượt sau, còn đoạn dán chỉ nằm trong một cuộc chat.
Vì sao AI trả lời đúng phần mở đầu nhưng sai ở chương giữa? Đó là hiện tượng "lạc ở giữa" mà nghiên cứu Lost in the Middle mô tả: mô hình dùng thông tin ở đầu và cuối ngữ cảnh tốt hơn ở giữa. Cách chữa là hỏi có vị trí cụ thể, hoặc chia tài liệu để phần cần hỏi không nằm giữa một khối quá dài.
File PDF scan thì tính token thế nào? PDF scan phải được nhận dạng chữ (OCR) trước khi AI đọc được. Sau OCR, số token tính theo chữ nhận dạng được, giống file văn bản thường. Bảng biểu và công thức phức tạp có thể bị nhận dạng sai, nên hãy kiểm tra các đoạn đó.
Chia nhỏ tài liệu có làm AI mất mạch liên kết giữa các chương không? Có, nếu bạn cắt giữa một ý hoặc không bao giờ ghép lại. Cắt theo ranh giới chương và có lượt tổng hợp cuối cùng (cách 3) là để giữ mạch đó.
Cửa sổ ngữ cảnh lớn hơn thì có cần chia để trị nữa không? Ít cần hơn, nhưng không phải không bao giờ. Khi tài liệu vượt cửa sổ, khi gộp nhiều tài liệu, hoặc khi bạn cần kiểm soát từng phần (ví dụ mỗi chương một người phụ trách), chia để trị vẫn là cách làm rõ ràng nhất.
Tài khoản miễn phí có xử lý được tài liệu dài không? Tài liệu càng dài thì mỗi câu hỏi càng tốn nhiều token. Tài khoản miễn phí có hạn mức theo phiên nên có thể hết hạn mức chỉ sau một vài câu hỏi trên tài liệu vài trăm trang. Với công việc thường xuyên trên tài liệu dài, gói trả phí phù hợp hơn.
Lưu ý và bài liên quan
Bài viết cập nhật 26/10/2026. Số token đo trực tiếp qua API của MiniMax và DeepSeek vào ngày này. Cửa sổ ngữ cảnh của các công cụ AI thay đổi theo thời gian và theo gói dịch vụ, nên hãy kiểm tra thông số hiện hành của công cụ bạn dùng.
Nguồn: Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, 12. arXiv:2307.03172.
Đọc tiếp trong cụm làm việc với văn bản dài bằng AI:
- Cách tóm tắt tài liệu 100 trang bằng AI mà không bị bịa
- Sửa một đoạn trong khoá luận 80 trang bằng AI mà không làm hỏng phần còn lại
- Kiểm tra nhất quán khoá luận, luận văn trước khi nộp
- Rà soát hợp đồng dài và phụ lục bằng AI
- Dịch 100 trang văn bản với AI
- Viết luận văn bằng AI: cách tiết kiệm thời gian nhất cho học viên thạc sĩ